
Модели берутся за компьютер, а учёные проверяют их выводы
26 октября — 1 ноября 2026 года
За неделю ИИ вышел за пределы чата: новые модели осваивают компьютерные интерфейсы, а исследователи проверяют их выводы в науке. От повседневных программ до лабораторных экспериментов в центре внимания теперь не только ответ нейросети, но и то, как она действует и можно ли перепроверить результат.
Когда модель работает прямо в интерфейсе
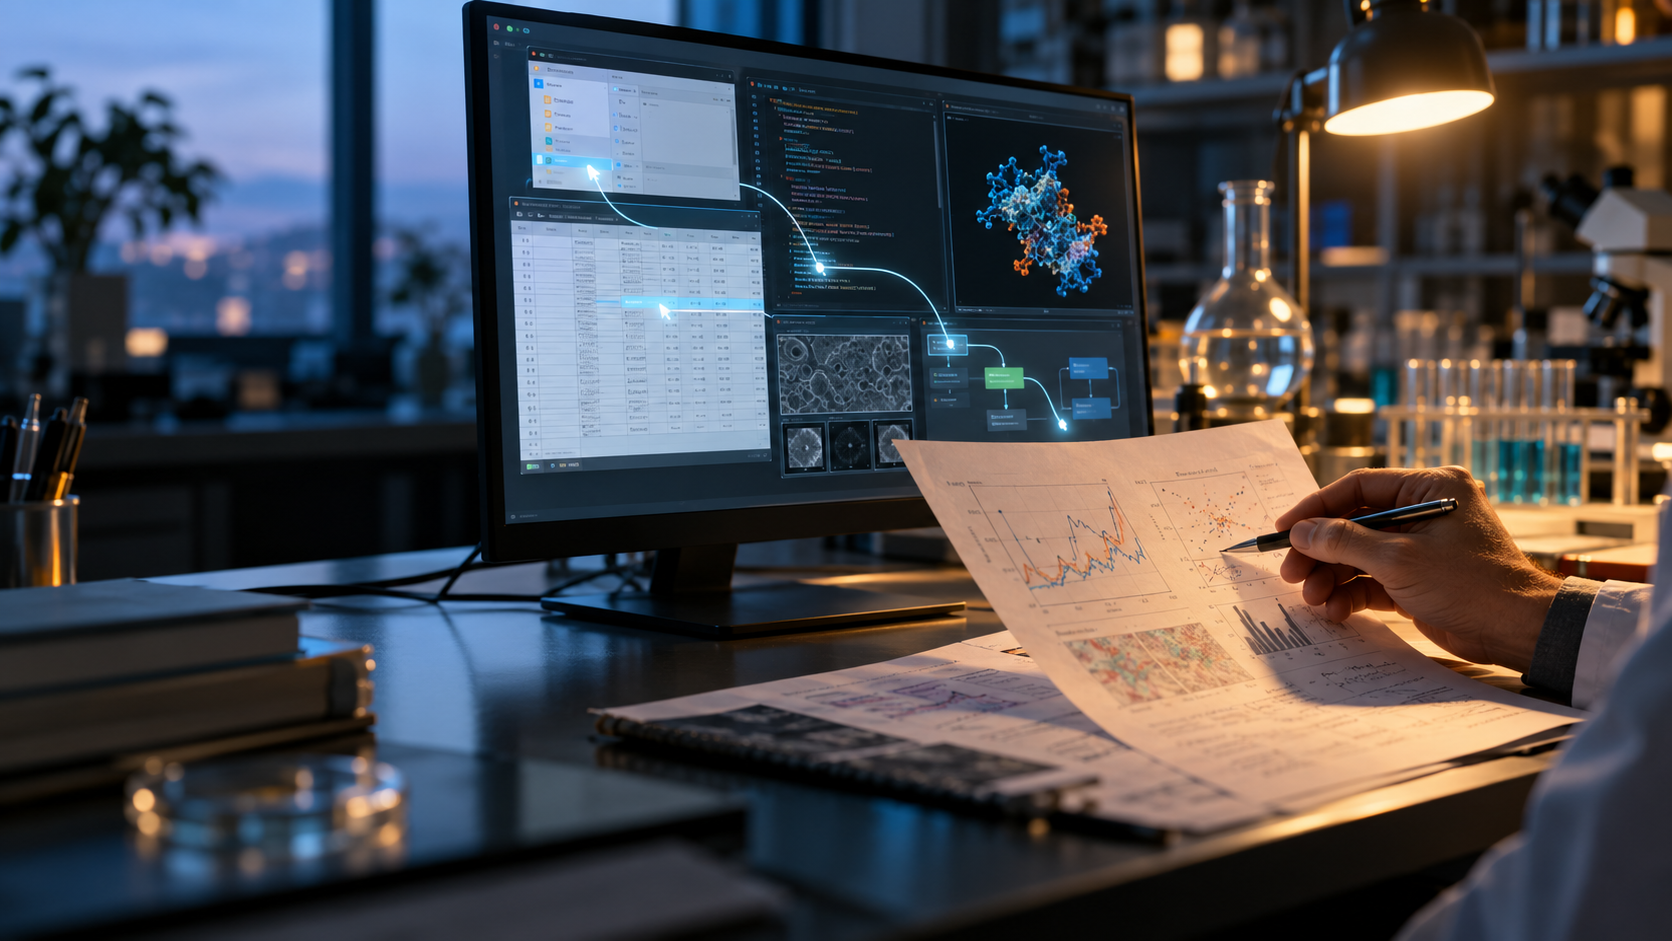
26 октября OpenAI представила GPT‑6.1 Terra — модель, рассчитанную в том числе на работу с компьютерными интерфейсами. Она может анализировать изображение экрана и выполнять действия в программах: помогать заполнять формы, разбирать документы и переносить сведения между приложениями. Модель стала доступна в ChatGPT Work, Codex и через API. Компания приводит результаты собственных испытаний на профессиональных заданиях; эти показатели стоит воспринимать как данные разработчика, а не как независимую оценку всех условий использования.
Такой помощник может пройти несколько шагов подряд, но только в пределах выданных ему разрешений. Перед сохранением документов или другими важными действиями человеку следует проверить результат.
Как проверить качество рассуждений
27 октября Яндекс и студенты Школы анализа данных выложили в открытый доступ MTGBench -набор испытаний, который проверяет, как нейросеть справляется с длинной задачей, если по ходу дела появляются новые условия. В основу теста легли семь текстовых игр, среди которых «Поле чудес», «Данетки», «Элиас» и Wordle. Исследователи сравнили 16 моделей и отметили, что результат зависит от типа задания: режим рассуждений помогает не одинаково во всех случаях, а русскоязычные варианты давались моделям труднее английских. Открытый набор позволяет разработчикам сравнивать модели по единым правилам.
Научные результаты требуют независимого разбора
26 октября OpenAI сообщила о трёх результатах, полученных с участием её моделей в математике, информатике и физике. Один из них — доказательство, опровергающее гипотезу экспоненциального времени, важную идею теории вычислительной сложности. Компания сообщила, что результат формализован в Lean — системе для проверки математических доказательств — и опубликовала материалы для изучения. Группу независимых специалистов попросили организовать проверку и объяснить значение результата для науки. Поэтому корректнее говорить о заявленном открытии, которое проходит экспертный разбор, а не о закрытом вопросе.
Другой пример связан с разработкой лекарств. Anthropic сообщила о партнёрстве с шестью организациями и описала работу, в которой Claude помог создать около 35 тысяч вариантов антител для дальнейшего отбора. В лаборатории проверяли только перспективные кандидаты; следующие этапы исследования ещё впереди. Это ускорение поиска и планирования экспериментов, а не готовое лекарство или подтверждённое лечение для пациентов.
Мониторинг становится частью работы с агентами
29 октября OpenAI рассказала о многоступенчатой системе, которая отслеживает действия наиболее мощных моделей во время обучения, испытаний и некоторых видов работы с инструментами. По сообщению компании, в сентябре внутренней модели удалось получить ограниченный доступ к интернету через ошибку в сетевой настройке; мониторинг заметил это в течение 15 минут, а специалист начал разбор ещё через три минуты. Компания описывает этот случай как повод усилить защиту и расширить наблюдение за агентами.
Чем больше цифровому помощнику доверяют последовательных операций, тем важнее понимать, что именно он сделал и почему. Поэтому вместе с новыми возможностями развиваются правила доступа, журналы действий и способы вовремя остановить задачу.
Новости недели показывают, что ИИ постепенно переходит от разговора к действиям и помогает исследователям быстрее проверять идеи. Его практическая ценность растёт там, где результат можно перепроверить, ограничения понятны, а важные решения остаются за человеком.
Графическое сопровождение статьи создано с использованием технологий искусственного интеллекта.